型構築とサイクル検出
Type Construction and Cycle Detection by Mark Freeman
Goの静的型付けは、堅牢性と信頼性が求められる本番システムにGoがうまく適合する理由の重要な一部です。 Goのパッケージがコンパイルされるとき、まずパースされます。つまり、そのパッケージ内のGoのソースコードが 抽象構文木(AST)に変換されるということです。このASTは続いてGoの 型チェッカー に渡されます。
この記事では、Go 1.26で大幅に改善された型チェッカーの一部分に踏み込んでみます。Goのユーザーの視点からは、 この変更によって何が変わるのでしょうか。よほど風変わりな型定義を好む人でない限り、目に見える変化はありません。 この改善はコーナーケースを減らすことを目的としたもので、Goの今後の改善に向けた足場を整えるものです。 また、Goプログラマにとってはごく普通に見えるものの、内部には実は微妙な複雑さが隠れているというのは、 見ていて面白いものでもあります。
しかしまずは、そもそも 型チェック とは何でしょうか。これはGoのコンパイラの中にあるステップで、 コンパイル時にエラーのクラス全体を排除するためのものです。具体的には、Goの型チェッカーは次のことを検証します。
- ASTに現れる型が妥当であること(たとえば、mapのキーの型は
comparableでなければなりません)。 - それらの型(あるいはその値)が関わる演算が妥当であること(たとえば、
intとstringを足すことはできません)。
これを実現するために、型チェッカーはASTを走査する中で出会った型それぞれについて内部表現を構築します。 この処理は非公式に 型構築 と呼ばれています。
すぐにわかるように、Goはシンプルな型システムで知られているとはいえ、型構築は言語のある種の隅々において、 見かけによらず複雑になりえます。
型構築
まずは単純な型宣言の組を考えることから始めましょう。
type T []U
type U *int
型チェッカーが呼び出されると、まず T の型宣言に出会います。ここで、ASTには型名 T と 型式
[]U からなる型定義が記録されています。T は定義型です。型チェッカーが定義型を
構築する際に使う実際のデータ構造を表すために、ここでは Defined という構造体を使うことにします。
Defined 構造体は、型名の右側にある型式に対応する型へのポインタを保持します。この underlying
フィールドは、その型の基底型を求めるために使われます。
型チェッカーの状態を説明する助けとして、ASTを歩くことでこれらのデータ構造がどのように埋まっていくかを、
次の状態から見ていきましょう。
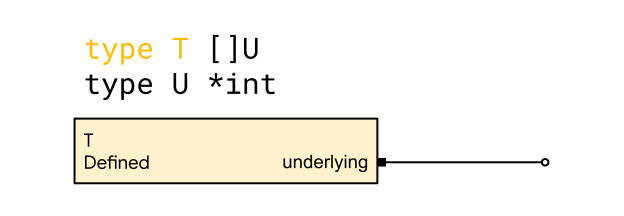
この時点では、T は 構築中 であり、黄色で示されています。まだ型式 []U を評価していない
(黒のまま)ため、underlying は nil を指しており、これは中抜きの矢印で示されています。
[]U を評価すると、型チェッカーはスライス型を表す内部データ構造である Slice 構造体を構築します。
Defined と同様に、これはスライスの要素型へのポインタを保持します。名前 U が何を指すのかはまだ
わかりませんが、型を指すことは期待できます。そのため、このポインタもまた nil です。次のようになります。
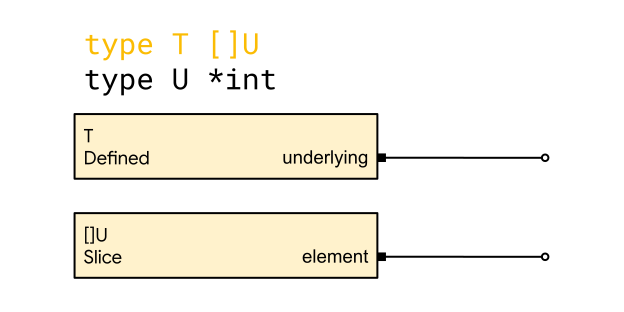
ここまでで大体の要領がつかめてきたと思うので、少しペースを上げていきましょう。
型名 U を型に変換するために、まずその宣言を探します。それが別の定義型を表していることがわかったら、
それに応じて U のための別の Defined を構築します。U の右側を調べると、型式 *int が見つかり、
これは Pointer 構造体に評価されます。このポインタが指す型は型式 int です。
int を評価すると、少し特別なことが起こります。あらかじめ宣言された型が返されるのです。あらかじめ
宣言された型は、型チェッカーがASTを歩き始めるよりも前に構築されています。int の型はすでに構築済み
なので、私たちがすべきことはその型を指すことだけです。
これで次のようになりました。
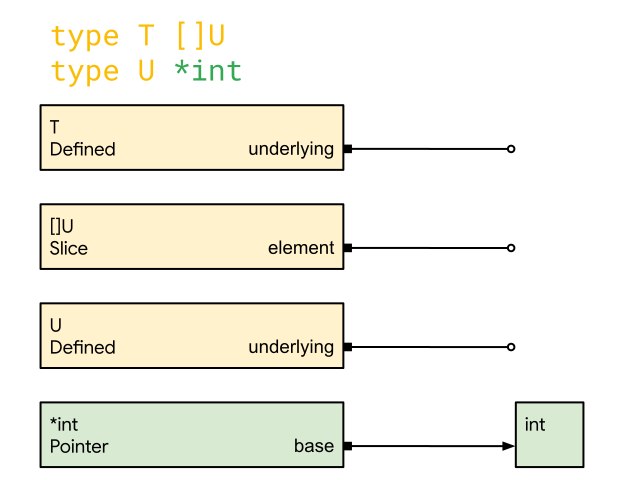
この時点で Pointer 型は 完成 しており、緑色で示されている点に注目してください。完成とは、
その型の内部データ構造のすべてのフィールドが埋まっており、それらのフィールドが指すどの型も完成して
いることを意味します。完成は型の重要な性質です。なぜなら、それによってその型の内部にアクセスすること、
すなわち 分解 が健全であることが保証されるからです。つまり、その型を説明する情報がすべて揃っている
ということです。
上の図では、Pointer 構造体は int を指す base フィールドしか持っていません。int には埋めるべき
フィールドがないため、これは「空虚に」完成しており、その結果 *int の型も完成することになります。
ここから型チェッカーはスタックを巻き戻し始めます。*int の型が完成しているので U の型を完成させる
ことができ、それはつまり []U の型を完成させられるということであり、T についても同様です。
この処理が終わると、下図のように完成した型だけが残ります。
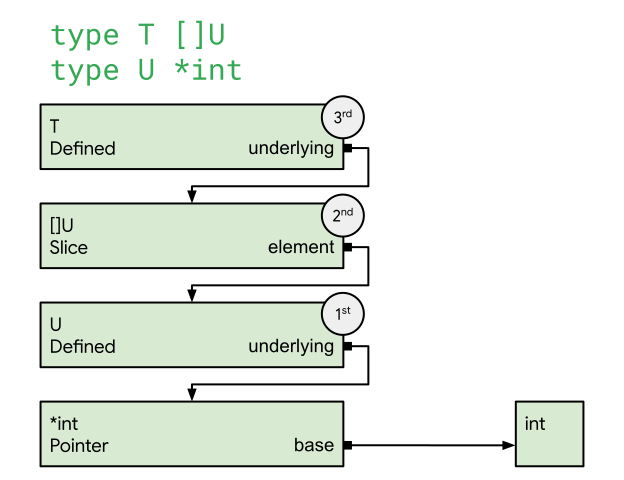
上図の番号は(Pointer の後に)型が完成した順序を示しています。一番下にある型が最初に完成したことに
注目してください。型を完成させるにはその依存先が先に完成している必要があるため、型構築は本質的に
深さ優先の処理になります。
再帰的な型
この単純な例を踏まえたうえで、もう少し込み入った話をしていきましょう。Goの型システムでは再帰的な型を 表現することもできます。典型的な例は次のようなものです。
type Node struct {
  next *Node
}
先ほどの例を見直して、*int を *T に入れ替えることで少し再帰性を加えてみましょう。
type T []U
type U *T
ではトレースしてみましょう。もう一度 T から始めますが、この変更による影響を示すために少し先まで
話を進めます。先ほどの例から予想できるように、型チェッカーは次のような状態で *T の評価に取りかかります。
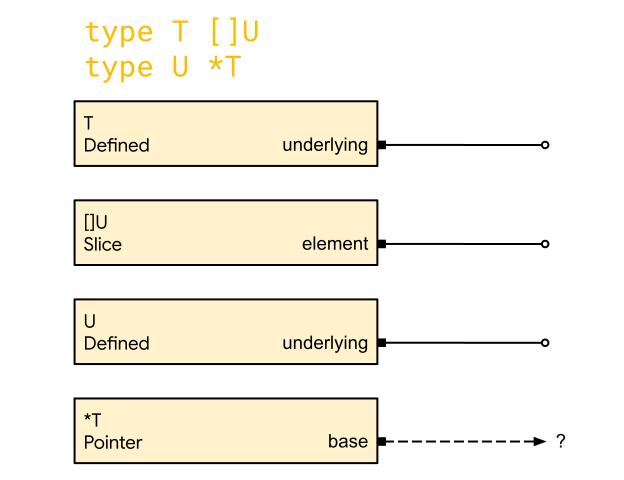
問題は *T が指す型をどう扱うかです。T が何であるか(Defined であること)はわかっていますが、
それは現在構築中です(underlying はまだ nil です)。
T が未完成であるにもかかわらず、単純に *T の指す型を T にします。
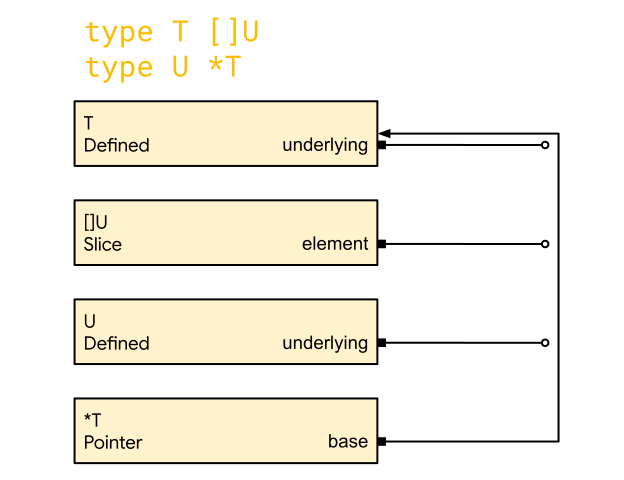
これは、T が(完成した型を指すことによって)将来的に構築を終えたときに完成する、という前提のもとで
行っています。それが起きれば、base は完成した型を指すことになり、その結果 *T も完成します。
その間に、スタックを遡り始めます。
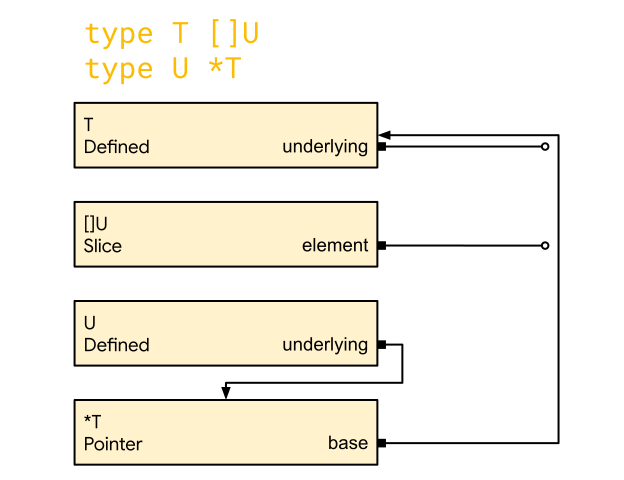
一番上まで戻って T の構築を終えると、型の「ループ」が閉じ、そのループの中にあるそれぞれの型が
同時に完成します。
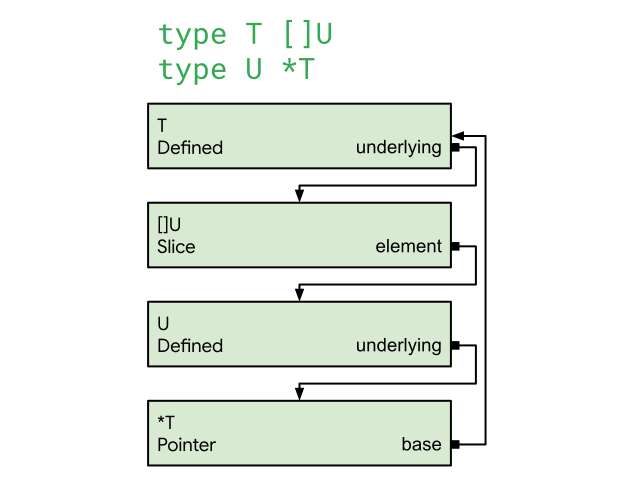
再帰的な型を考える前は、型式を評価すると常に完成した型が返ってきていました。これは便利な性質でした。 というのも、評価から返される型を型チェッカーが常に分解(内部を覗くこと)できるということを意味していた からです。
しかし先ほどの例では、T を評価すると 未完成 の型が返ってきました。つまり、T が完成するまでは
それを分解することは健全ではありません。一般的に言えば、再帰的な型があるということは、型チェッカーは
もはや評価から返される型が完成しているとは仮定できないということを意味します。
それでも、型チェックには型の分解を必要とするチェックがたくさんあります。典型的な例は、mapのキーが
comparable であることを確認する処理で、これには underlying フィールドを調べる必要があります。
では、T のような未完成の型と安全にやり取りするにはどうすればよいのでしょうか。
型の完成が、その型を分解するための前提条件であったことを思い出してください。今回のケースでは、 型構築は型を分解することは一切なく、単に型を参照しているだけです。言い換えると、ここでは型の完成が 型構築を妨げることはありません。
型構築が妨げられないため、型チェッカーはそうしたチェックを、すべての型が完成する型チェックの最後まで 単純に遅らせることができます(このチェック自体も型構築を妨げないことに注意してください)。ある型が 型エラーを明らかにするとしても、そのエラーが型チェックの中のいつ報告されるかは問題ではなく、最終的に 報告されさえすればよいのです。
この知識を踏まえて、未完成の型の値が関わる、もう少し複雑な例を見てみましょう。
再帰的な型と値
少し寄り道をして、Goの配列型を見てみましょう。配列型はサイズを持ち、
このサイズは型の一部である定数です。組み込み関数 unsafe.Sizeof
や len のような一部の演算は、特定の値や式
に適用されると定数を返すことがあり、そのため配列のサイズとして現れることができます。これらの関数に
渡される値はどんな型でもよく、未完成の型であってもかまいません。こうした値を 未完成の値 と呼びます。
次の例を考えてみましょう。
type T [unsafe.Sizeof(T{})]int
これまでと同じように、次のような状態に到達します。
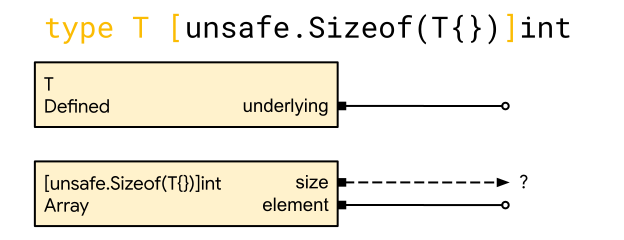
Array を構築するには、そのサイズを計算しなければなりません。値式 unsafe.Sizeof(T{}) からすると、
それは T のサイズです。(T のような)配列型のサイズを計算するには分解が必要です。つまり、配列の
長さと各要素のサイズを求めるために、型の内部を見る必要があります。
言い換えると、Array の型構築は T を分解 する ことになり、Array は T が完成する前には
構築を終える(ましてや完成する)ことができません。先ほど使った、ループを開始した型が構築を終えると
同時に型のループ全体が完成するという「ループ」の手法は、ここでは通用しません。
これにより、私たちは行き詰まってしまいます。
TはArrayが完成するまで完成できない。ArrayはTが完成するまで完成できない。- (これまでとは違って)両者を同時に完成させることはできない。
これは明らかに満たしようがありません。型チェッカーはどうすればよいのでしょうか。
サイクル検出
根本的に、このようなコードは無効です。なぜなら、型チェッカーがどのように動作するかにかかわらず、
T のサイズを知らなければ T のサイズを決定できないからです。この特定のケース、つまりサイズの
循環定義は、Goの構成要素の循環的な定義全般に関わる サイクルエラー と呼ばれるエラーのクラスの
一部です。別の例として type T T を考えてみると、これも理由は異なりますがこのクラスに属します。
型チェックの過程でサイクルエラーを見つけて報告する処理は サイクル検出 と呼ばれます。
では、type T [unsafe.Sizeof(T{})]int に対してサイクル検出はどのように働くのでしょうか。それを
知るために、内側の T{} を見てみましょう。T{} は複合リテラル式なので、型チェッカーはその結果の
値が T 型であることを知っています。T が未完成であるため、値 T{} のことを 未完成の値 と
呼びます。
ここは注意が必要です。未完成の値に対する操作が健全であるのは、その値の型を分解しない場合に限られます。
たとえば、type T [unsafe.Sizeof(new(T))]int は健全です。なぜなら値 new(T)(型は *T)は決して
分解されないからです。すべてのポインタは同じサイズを持ちます。繰り返しになりますが、*T 型の
未完成の値のサイズを求めるのは健全ですが、T 型の未完成の値についてはそうではありません。
これは、*T の「ポインタらしさ」が unsafe.Sizeof にとって十分な型情報を提供するのに対し、単なる
T はそうではないからです。実のところ、型が定義型であるような未完成の値に対して操作を行うことは
決して健全ではありません。なぜなら、単なる型名は基底型についての情報を一切伝えないからです。
どこで行うか
ここまでは、未完成かもしれない値に対して unsafe.Sizeof が直接操作を行うケースに注目してきました。
type T [unsafe.Sizeof(T{})]int では、unsafe.Sizeof の呼び出しは配列長の式の「根」にすぎません。
未完成の値 T{} が、他の値式の中のオペランドになっている場合も容易に想像できます。
たとえば、関数に渡されたり(type T [unsafe.Sizeof(f(T{}))]int)、スライスされたり
(type T [unsafe.Sizeof(T{}[:])]int)、インデックスされたり(type T [unsafe.Sizeof(T{}[0])]int)
することがあり得ます。これらはいずれも T の分解を必要とするため無効です。たとえば T を
インデックスするには T の基底型を確認する必要があります。
これらの式は未完成かもしれない値を「消費する」ため、これらを ダウンストリーム と呼ぶことに
しましょう。ダウンストリーム演算子の例は他にもたくさんあり、その中には構文的に自明ではないものも
あります。
同様に、T{} は未完成かもしれない値を「生み出す」式の一例に過ぎません。このような種類の式を
アップストリーム と呼ぶことにしましょう。
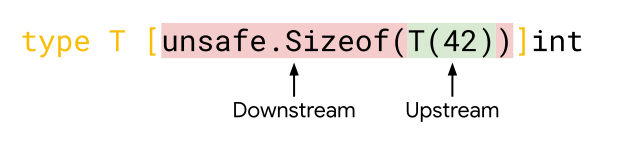
比較すると、未完成の値になりうる値式の方が数が少なく、構文的にもより自明です。また、Goの構文定義を 調べることでこうしたケースを列挙するのは比較的簡単です。こうした理由から、未完成かもしれない値が 生じる起点であるアップストリームを通じてサイクル検出のロジックを実装する方が単純になります。 以下にその例をいくつか示します。
type T [unsafe.Sizeof(T(42))]int                // 変換

func f() T
type T [unsafe.Sizeof(f())]int                  // 関数呼び出し

var i interface{}
type T [unsafe.Sizeof(i.(T))]int                // アサーション

type T [unsafe.Sizeof(<-(make(<-chan T)))]int   // チャネル受信

type T [unsafe.Sizeof(make(map[int]T)[42])]int  // mapアクセス

type T [unsafe.Sizeof(*new(T))]int              // デリファレンス

// ...ほかにもいくつか
これらのケースそれぞれについて、型チェッカーにはその種類の値式が評価される箇所に追加のロジックが あります。結果の値の型がわかった時点で、その型が完成しているかどうかを確認する単純なテストを 挿入します。
たとえば、変換の例である type T [unsafe.Sizeof(T(42))]int では、型チェッカーの中に次のような
コードがあります。
func callExpr(call *syntax.CallExpr) operand {
  x := typeOrValue(call.Fun)
  switch x.mode() {
  // ...その他のケース
  case typeExpr:
    // T()、つまり変換であることを意味する
    T := x.typ()
    // ...変換を処理する。Tを分解するのは安全ではない
  }
}
CallExpr が T への変換であると分かった時点で、(それより前にエラーがなければ)結果の型が T に
なることがわかります。型チェッカーの残りの部分に T 型の値(ここでは operand)を返す前に、T
が完成しているかどうかを確認する必要があります。
func callExpr(call *syntax.CallExpr) operand {
  x := typeOrValue(call.Fun)
  switch x.mode() {
  // ...その他のケース
  case typeExpr:
    // T()、つまり変換であることを意味する
    T := x.typ()
+   if !isComplete(T) {
+     reportCycleErr(T)
+     return invalid
+   }
    // ...変換を処理する。Tを分解するのは安全である
  }
}
未完成の値を返す代わりに、特別な invalid オペランドを返します。これは、その呼び出し式を評価
できなかったことを示すものです。型チェッカーの残りの部分には、invalid オペランドに対する特別な
処理があります。これを加えることで、未完成の値が型変換ロジックの残りの部分やダウンストリーム演算子
へと下流に「漏れ出す」ことを防ぎ、代わりに T に関する問題を説明するサイクルエラーを報告するように
しました。
同様のコードパターンが他のすべてのケースでも使われており、未完成の値に対するサイクル検出を実装して います。
結論
未完成の値に関わる体系的なサイクル検出は、型チェッカーへの新しい追加機能です。Go 1.26より前は、 より複雑な型構築アルゴリズムを使っていて、そこにはより場当たり的なサイクル検出が組み込まれており、 常にうまく機能するわけではありませんでした。私たちの新しい、よりシンプルなアプローチは、 (正直なところ難解ではありますが)多数のコンパイラのパニック(issue #75918、 #76383、#76384、#76478 など)に対処し、より安定した コンパイラをもたらしました。
プログラマとして、私たちは再帰的な型定義やサイズ付きの配列型といった機能に慣れ親しんでいるため、 その背後にある複雑さのニュアンスを見落としがちです。この記事では細かい部分をいくつか省略していますが、 Goにおける型チェックを取り巻く問題について、より深い理解(そしておそらくは、その面白さへの理解)を お伝えできていれば幸いです。
By Mark Freeman